Kafka가 뭐야?
Kafka를 이해할 때는 이벤트를 저장하는 로그와, 그 로그를 읽는 위치가 분리되어 있다는 점부터 보는 것이 좋습니다. 어떤 Consumer가 읽었다고 이벤트가 즉시 사라지지 않으므로 여러 서비스가 독립적으로 처리하거나 필요할 때 다시 읽을 수 있어요.
 Apache Kafka
이 글은 Kafka의 기본 개념을 일반적인 Consumer Group 기준으로 설명합니다. 원문 작성 시점은 2023년이며, 버전에 따라 달라지는 부분은 따로 구분했습니다.
Kafka를 어디에 쓸까?
예를 들어 주문이 생성됐을 때 알림 서비스와 통계 서비스가 각각 그 사실을 알아야 한다고 해봅시다. 주문 서비스가 각 서비스의 완료를 기다리는 대신 이벤트를 Kafka에 기록하고, 두 서비스는 자신의 속도로 처리할 수 있어요.
Kafka는 이벤트 발행·구독, 보관, 스트림 처리를 지원하는 분산 이벤트 스트리밍 플랫폼입니다. 단순한 작업 큐로도 사용할 수 있지만, 같은 이벤트를 여러 목적에 사용하고 다시 처리할 필요가 있을 때 로그를 보관하는 특징이 특히 유용합니다. Kafka 공식 개요
분리가 모든 의존성을 없애는 것은 아닙니다. Producer와 Consumer는 이벤트의 스키마와 의미를 공유해야 하고, 즉시 완료되던 일을 나누면 처리 지연과 부분 실패를 제품에서 다뤄야 합니다. 비동기라는 이유만으로 Kafka가 꼭 필요한 것도 아니에요. 작은 규모의 단일 백그라운드 작업이라면 기존 DB를 활용한 작업 관리와 운영 비용을 비교해볼 수 있습니다.
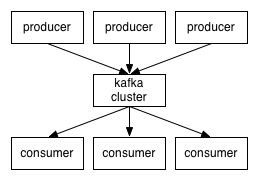 Producer는 이벤트를 기록하고 Consumer는 필요한 이벤트를 가져옴
구성요소를 하나의 예제로 연결하기
| 구성요소 | 역할 | 주문 이벤트 예시 |
|---|---|---|
| Event / Record | 주고받는 데이터 단위 | order.created, 주문 ID, 발생 시각 등의 데이터 |
| Producer | 이벤트를 Kafka에 기록 | 주문 서비스 |
| Broker | 로그를 저장하고 클라이언트 요청을 처리하는 Kafka 서버 | 클러스터를 이루는 서버 |
| Topic | 관련 이벤트를 담는 논리적 이름 | orders |
| Partition | Topic을 나눈 순서 있는 로그 | orders의 0·1·2번 Partition |
| Consumer | 이벤트를 가져와 처리 | 알림·통계 서비스의 프로세스 |
| Consumer Group | Partition을 나눠 읽고 처리 위치를 공유하는 Consumer 묶음 | notifications, analytics라는 별도 그룹 |
ZooKeeper는 과거 Kafka 구성에서 메타데이터 관리와 컨트롤러 선출 등에 사용했습니다. 2023년에도 KRaft 구성이 있었으며, Kafka 4.0부터는 ZooKeeper 모드가 제거됐습니다. 따라서 현재 구성요소를 외울 때 ZooKeeper를 필수로 포함하면 안 됩니다. Kafka 4.0 변경 사항
Partition이 순서와 병렬성의 경계인 이유
하나의 Partition에는 이벤트가 로그 순서대로 기록됩니다. Kafka가 제공하는 순서는 Partition 내부의 순서이지 Topic 전체의 순서는 아닙니다. 여러 Partition의 이벤트를 한데 모아도 전역 순서가 자동으로 생기지 않아요.
같은 주문의 변경 이벤트를 같은 Partition에 보내려면 주문 ID를 키로 사용할 수 있습니다. 다만 키로 분배하는 partitioner를 사용하고 Partition 수와 분배 규칙이 유지된다는 조건이 필요해요. Partition 수를 늘리면 같은 키가 이전과 다른 Partition에 배치될 수 있습니다. Producer의 분배 방식
같은 Partition으로 보냈더라도 애플리케이션이 후속 작업을 무작위로 병렬 실행하면 완료 순서는 달라질 수 있습니다. 주문별 상태 변경처럼 순서가 중요하다면 키 선정, 발행 순서와 재시도 설정, Consumer의 처리 방식까지 함께 봐야 합니다.
Consumer를 늘리면 언제 빨라질까?
일반적인 Consumer Group에서 각 Partition은 그룹 안의 하나의 Consumer에 할당됩니다. 하나의 Consumer가 여러 Partition을 담당할 수는 있지만, 같은 그룹의 여러 Consumer가 같은 Partition을 동시에 나눠 담당하는 구조는 아닙니다.
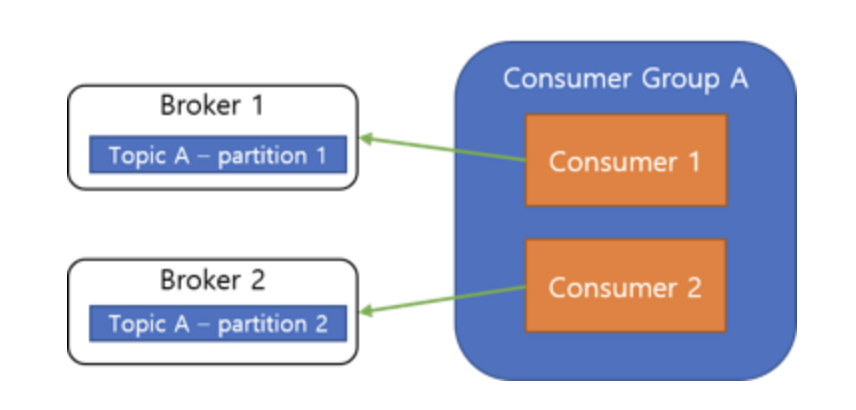 그룹 안에서 Partition을 나눠 처리하는 관계
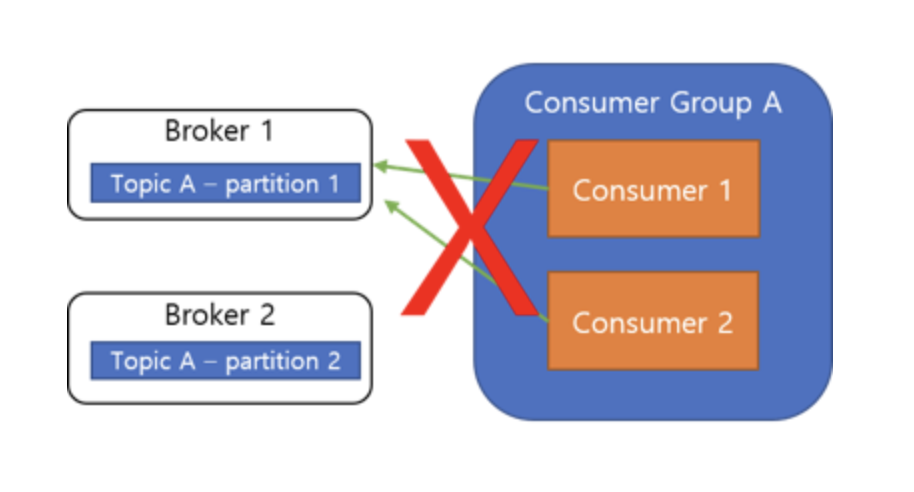 동일 Partition을 같은 그룹의 여러 Consumer에 중복 할당하는 그림은 일반적인 그룹 모델과 맞지 않음
orders Partition 수 |
같은 그룹의 Consumer 수 | 할당 관점의 결과 |
|---|---|---|
| 3 | 1 | 하나가 세 Partition 담당 |
| 3 | 3 | 각자 하나씩 맡을 수 있음 |
| 3 | 5 | 적어도 두 Consumer는 담당 Partition이 없음 |
알림과 통계가 서로 다른 group ID라면 둘 다 같은 이벤트를 독립적으로 읽습니다. 같은 group ID를 쓰면 작업을 나눠 받기 때문에 두 서비스 모두 이벤트를 받으리라는 기대와 달라집니다. 그룹의 멤버가 바뀌거나 장애가 나면 할당을 조정하는 rebalance가 일어납니다. Consumer Group과 할당 설명
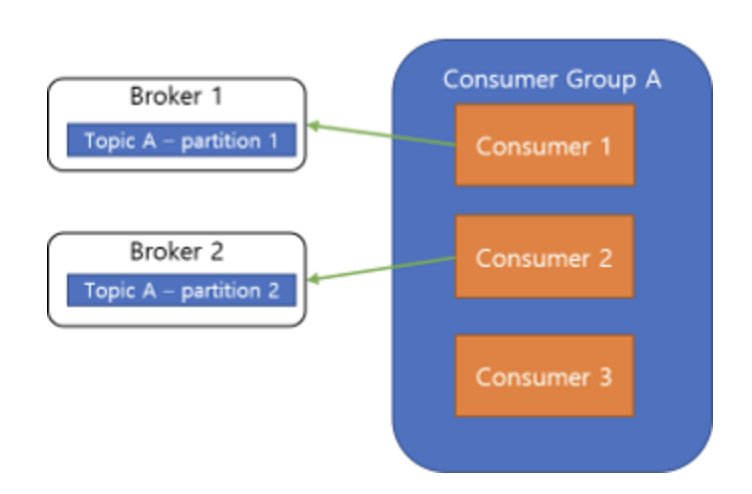 할당할 Partition이 없으면 Consumer 증설만으로 병렬성이 늘지 않음
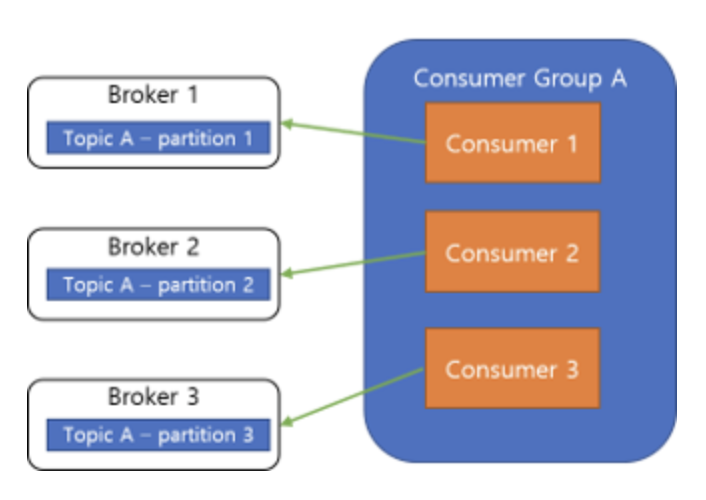 Partition이 충분해도 처리 병목과 키별 트래픽 편중은 별도 확인이 필요함
Consumer를 늘릴 때마다 Partition을 함께 늘릴 필요는 없습니다. 이미 충분한지부터 확인하세요. 특정 주문 키에 트래픽이 몰리거나 외부 DB가 병목이면 Consumer 수를 늘려도 기대만큼 빨라지지 않을 수 있습니다.
Offset과 commit: 읽은 위치와 복구 위치
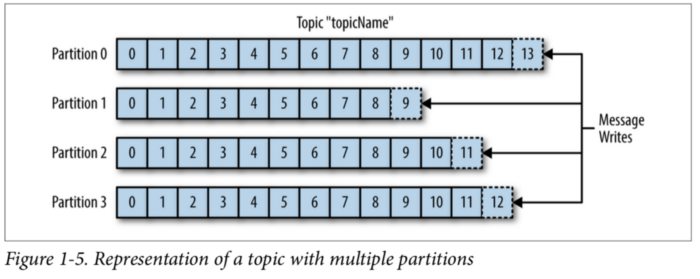 Offset은 Partition 안에서의 로그 위치이며 전체 Topic의 공통 번호가 아님
Consumer에는 현재 읽기 위치와 저장한 commit offset이 있습니다. commit offset은 재시작이나 재할당 후 이어 읽을 위치입니다. 보통 마지막으로 처리한 레코드의 offset에 1을 더한 값을 저장합니다. 정상 실행 중 매번 commit 위치로 돌아가는 것은 아닙니다. KafkaConsumer의 position과 committed position
예를 들어 42번 이벤트를 처리한 뒤 43을 commit한다고 해봅시다.
| 장애 시점 | 재시작 후 가능한 결과 | 설계에서 필요한 것 |
|---|---|---|
| 43을 먼저 commit하고 42번 업무 처리 전에 종료 | 42번을 건너뛰어 업무 누락 | 처리와 commit 순서 검토 |
| 42번 업무 처리 성공 후, 43 commit 전에 종료 | 42번이 다시 전달되어 중복 처리 | 멱등한 업무 처리 |
| 업무 결과와 복구 위치를 같은 트랜잭션에 기록 | 그 저장 범위 안에서 원자성 확보 가능 | 대상 저장소와 Consumer 복구 방식의 연동 |
그래서 “처리한 뒤 commit하면 중복이 없다”는 설명은 틀립니다. 외부 DB를 갱신한다면 이벤트 ID의 처리 기록과 업무 변경을 같은 DB 트랜잭션에 넣어 중복 반영을 막는 방식을 고려할 수 있어요. 처리 ID부터 별도로 저장한 뒤 업무 처리에 실패하면 오히려 재시도를 막아 누락될 수 있습니다. 외부 저장소와 offset을 함께 관리하는 예시
보관·복제·전달 보장은 다른 문제
느린 Consumer를 Kafka가 영원히 기다려주지는 않음
Consumer는 Broker에서 이벤트를 가져오는 pull 방식을 사용합니다. 자신의 속도로 읽고 배치 처리하기 좋지만, 생산 속도보다 처리가 느리면 lag가 쌓입니다. 처리 지연을 볼 때는 offset 차이뿐 아니라 가장 오래 밀린 이벤트의 나이도 함께 보면 업무 영향을 이해하기 쉽습니다.
읽지 않은 이벤트라도 보존 정책에 따라 삭제될 수 있습니다. offset을 과거로 돌려도 이미 사라진 이벤트는 되살릴 수 없어요. 또 compaction을 사용하는 Topic은 같은 키의 옛 값을 정리하므로, 모든 변경 이력을 그대로 보관하는 용도와 구분해야 합니다. Topic의 보관·정리 설정
복제했다고 모든 장애에서 안전한 것은 아님
복제본 수와 Producer의 성공 응답 조건도 함께 봐야 합니다. acks=all은 설정된 모든 복제본이 아니라 현재 ISR(in-sync replicas)에 속한 복제본의 확인을 기다립니다. 허용할 최소 ISR 수와 함께 구성해야 장애 시 쓰기를 계속 받을지 중단할지 결정할 수 있어요. 이 보장은 Consumer의 업무 처리가 끝났다는 뜻은 아닙니다. Producer의 acks 설정
Exactly once의 범위 확인하기
| 전달·처리 의미 | 감수하는 것 또는 조건 |
|---|---|
| At most once | 중복을 피하는 대신 장애 시 처리가 누락될 수 있음 |
| At least once | 재전달과 중복 처리를 허용하고 누락을 줄이는 방식. 보관·복구 등 전제가 필요함 |
| Exactly once | 정해진 처리 범위에서 결과가 한 번 반영되도록 설계. 외부 부수 효과까지 자동 보장하지 않음 |
Kafka 트랜잭션과 Kafka Streams 등은 Kafka의 읽기·처리·쓰기를 묶는 데 사용할 수 있습니다. 그러나 이메일 발송이나 외부 결제 API까지 자동으로 한 번만 실행해주지는 않습니다. “무엇이 어디까지 한 번인가?”를 시스템 경계와 함께 정해야 합니다. Kafka의 전달 보장 설명
Kafka 도입 전에 답할 질문은 세 가지입니다. 무엇을 기준으로 순서를 지킬지, 중복 처리와 재처리를 어떻게 감당할지, 이벤트를 얼마나 보관할지입니다. 이 답이 있어야 Partition 수와 Consumer 수 같은 설정도 업무 요구에 연결할 수 있어요.